Umi Blog
ウミブログ
こんにちは、スタジオ・ウミの大野です。
このたび、Drupalのコントリビュートモジュール Japanese Transliteration をdrupal.org上で公開しました。日本語のDrupalerなら一度は「あれ?」と感じたことがあるはずの、あの音訳(transliteration)の違和感を解消するためのモジュールです。
実はこの課題、drupal.org上で議論が始まったのは 今から13年近く前。そして私自身、1年前に一度挑んだものの公開までは果たせず、ずっとモヤモヤしていたテーマでもあります。それがようやく形になり、正直とてもうれしいです。
まずは「何がうれしいのか」を、具体的な違和感からご紹介させてください。
Drupalでは、日本語のラベルからマシンネームやURLエイリアスを自動生成するとき、漢字がローマ字に変換されます。ところが、その変換結果は日本語として読めない 謎のローマ字 になってしまうのです。
たとえば「無形文化遺産」というコンテンツタイプを追加すると、システム内部名称(マシンネーム)はこうなります。

本来期待したいのは mukei_bunka_isan ですが、実際に生成されるのは wu_xing_wen_hua_yi_chan。この綴りは、中国語の発音をアルファベットで表す「ピンイン(拼音)」に由来します。ピンインは、いわば中国語版のローマ字で、漢字を1文字ずつ中国語読みで並べたものです。日本語として読むと意味が通じず、マシンネームやURLとしても直感的ではありません。
ラベル:無形文化遺産 → マシンネーム:wu_xing_wen_hua_yi_chan
そもそも、この「文字をローマ字に置き換える処理」には 音訳(transliteration) という名前があります。意味を訳す「翻訳」とは違い、音訳は 発音に基づいて別の文字体系に置き換える 処理です。日本語ラベルからマシンネームやURLを生成するとき、Drupalは裏側でこの音訳を自動的に実行しています。ふだん意識することはあまりありませんが、今回の話はすべて、この裏方の処理をめぐるものです。
そして問題の原因は、Drupalコアに同梱されている音訳データにあります。
漢字(CJK統合漢字)は日本語・中国語・韓国語で共有される文字ですが、コアの音訳テーブルは これらの漢字を一律に中国語(ピンイン)読みでローマ字化 します。コアからすれば「漢字=中国語読み」で処理するのが最も広くカバーできる、という判断なのですが、日本語コンテンツを扱う私たちにとっては、これが冒頭の違和感の正体になります。
そしてこの問題、決して新しいものではありません。drupal.orgのコミュニティで最初に提起されたのは 2012年のこのスレッド。なんと13年近くも前のことです。それだけ長く「日本語Drupalerあるある」として共有され続けてきた、根の深いテーマなのです。
私がこの課題に本腰を入れて取り組んだのは、ちょうど1年前(2025年7月)に開催された Drupal Contribution Day Japan 2025(connpass)でした。
コントリビューションデーは、Drupalerが集まってコアやモジュールへの貢献に取り組むイベントです。このとき私は同僚の小林と組んで「ピンイン変換問題」に挑み、形態素解析で読みを取ってローマ字化するPoC(概念実証)までは形にできました。ただ、そこから公開できる品質のモジュールに仕上げるところまでは至らず、宿題として持ち帰ることになりました。
「いつか必ずちゃんと形にしたい」。その宿題を、1年越しでようやく提出できたのが今回の公開です。
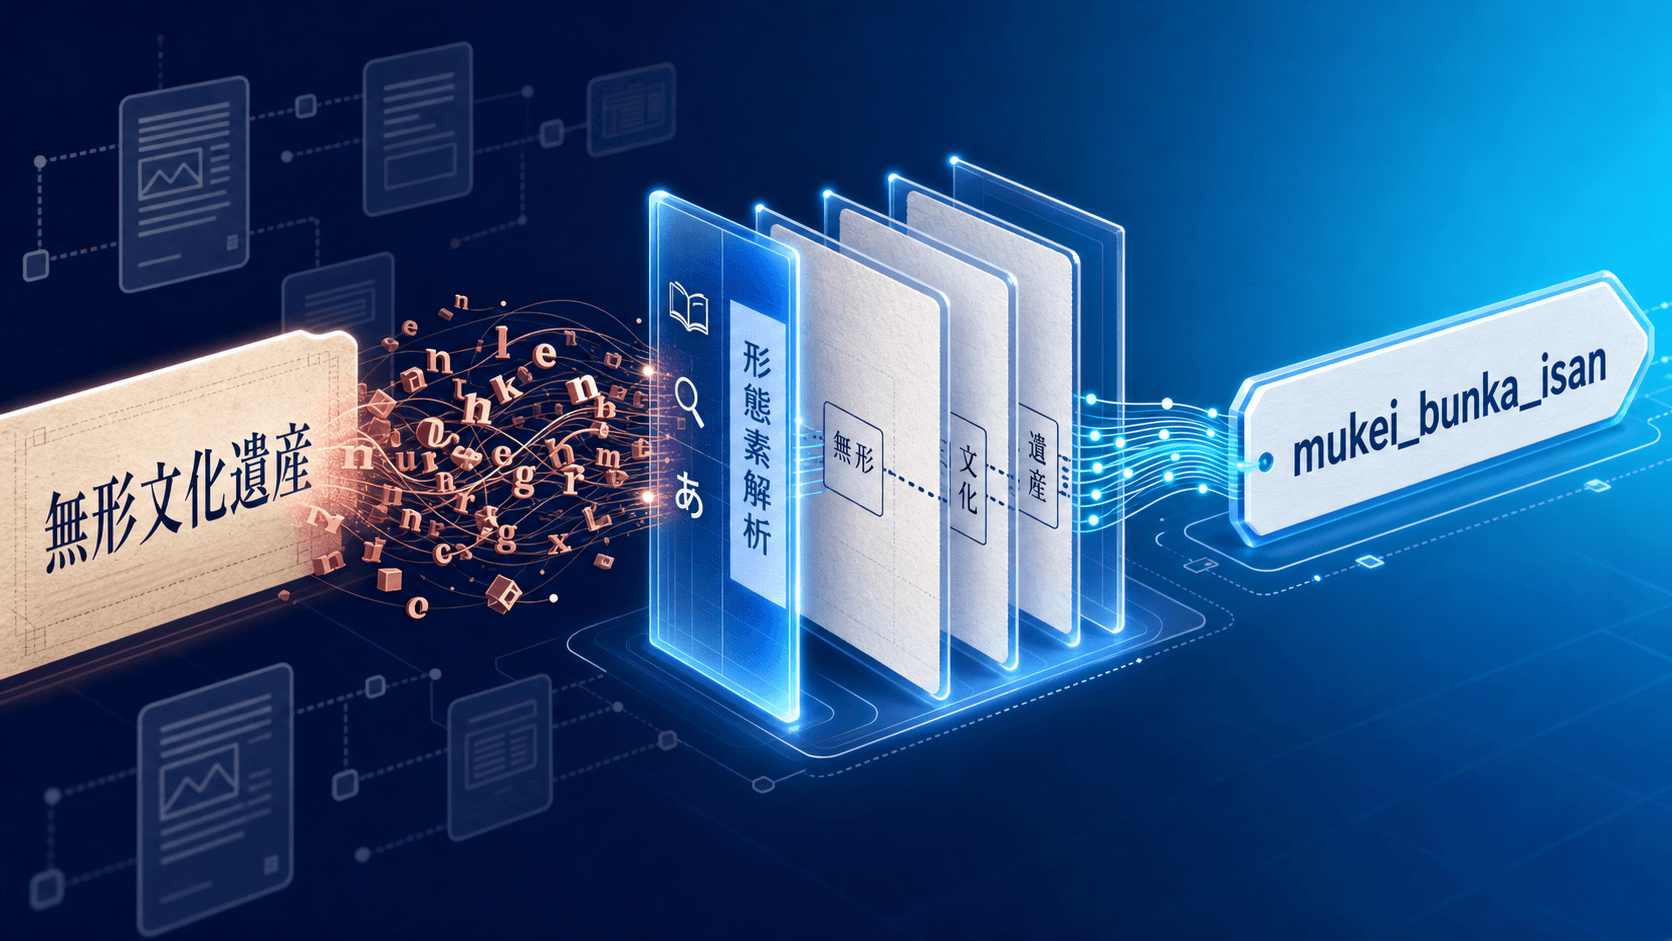
このモジュールを有効にすると、コアの transliteration サービスに 日本語対応の層 が追加されます。仕組みはシンプルで、大きく次の流れで動きます。
形態素解析には、別途開発した JNLP モジュール を利用します。Sudachi・MeCab・Igo-phpといった解析器のいずれかを通じて「日本語→ローマ字」ではなく、「日本語→読み→ローマ字」 という一段階を挟むのがポイントです。これにより、辞書に基づいた自然な読みでローマ字化できます。
無形文化遺産 → ムケイブンカイサン → mukei_bunka_isan
冒頭の wu_xing_wen_hua_yi_chan が、ようやく期待どおりの mukei_bunka_isan になりました。
いま見た mukei_bunka_isan のように、単語(品詞)の区切り が _ で残るのもこのモジュールの特徴です。コアのピンイン変換は漢字を1文字ずつ処理するため、wu_xing_wen_hua_yi_chan のように語がひと続きにつながってしまいます。一方このモジュールは、形態素解析で文をいったん単語に分けてから変換するので、「無形」「文化」「遺産」という語の境目がそのまま残ります。こうした語は英語に訳すと「intangible cultural heritage」のように長くなりがちで、ラベルとしてはローマ字のほうが素直です。
漢字は中国語とも共有される文字なので、「漢字が来たら何でも日本語読みにする」わけにはいきません。そこでこのモジュールでは、次のように切り分けています。
この切り分けによって、中国語コンテンツの音訳には影響しないよう配慮しています。
ローマ字の綴りには流派があります。このモジュールでは設定画面から 日本式・訓令式・ヘボン式 を選べます。たとえば同じ読みでも、次のように綴りが変わります。
| かな | 日本式 | 訓令式 | ヘボン式 |
|---|---|---|---|
| シ | si | si | shi |
| チ | ti | ti | chi |
| ツ | tu | tu | tsu |
| ジ | zi | zi | ji |
| ヂ | di | zi | ji |
| ヅ | du | zu | zu |
たとえば「写真(シャシン)」なら、日本式・訓令式では syasin、ヘボン式では shashin となります。日本式と訓令式の違いは「ぢ・づ」などに現れます。「続き(ツヅキ)」なら、日本式 tuduki・訓令式 tuzuki・ヘボン式 tsuzuki と、3方式それぞれ異なる綴りになります。長音の扱い(「コーヒー」を koohii とするか kohi とするか、など)も設定で選べるようにしてあります。
地味に工夫が必要だったのは、マシンネームの入力プレビュー(ラベルを打つと下に候補が出るあれ)への対応です。
このプレビューの仕組みは、Drupalのバージョンによって変わってきました。かつてはブラウザーがサーバー側のエンドポイントに問い合わせて音訳していました。しかしこのエンドポイントは、Drupal 10.2で非推奨 となり、その後 11.0で削除 されました。以降、マシンネームの音訳は ブラウザー側のJavaScriptだけ で完結するようになっています(コアの変更履歴)。
ところが、このコア同梱のJSも漢字をピンイン読みで変換します。そして厄介なことに、日本語の読みは辞書を引かないと決まらない ため、JavaScriptだけで正しい読みを得るのは現実的に不可能です。形態素解析器と辞書は、サーバー側(PHP + Sudachiなど)にしかありません。
そこでこのモジュールは、コア本来のマシンネームの挙動を 上書き(オーバーライド) し、最後に日本語のローマ字変換を差し込みます。流れはこうです。
入力のたびにサーバーへ問い合わせが殺到しないよう少し待ってからまとめて問い合わせ、古い問い合わせはキャンセルします。問い合わせに失敗しても、コアのピンイン候補が残るだけなので壊れません。下の様子が、その「一瞬ピンインが出て、すぐ日本語読みに切り替わる」動きです。

このモジュールがうれしいのは、影響範囲がマシンネームにとどまらない点です。コアの音訳サービスを経由する処理は、まとめて日本語読みに変わります。
個人的にとくに推したいのが URLエイリアス です。
いまはURLに日本語をそのまま使ってもほとんど問題なく動きます。ただ、日本語のURLは共有すると %E6%9D%B1... のようにパーセントエンコードされ、長くてごちゃごちゃした文字列になりがちです。これを嫌って、ASCIIのURLで統一したいという運用も根強くあります。
その場合に活躍するのが Pathauto モジュール の設定です。/admin/config/search/path/settings で、「URLエイリアスを生成する前に翻訳を行う」を有効にすると、日本語タイトルから作られるURLも音訳されます。

たとえば、パスパターンに page/[node:title] を設定したとします。

この状態でタイトル「東京の猫」の記事を作ると、URLはこうなります。

できあがったURLは /page/toukyou-no-neko。従来ならピンイン読みの dong-jing-no-mao のような綴りになるところ、日本語話者なら一目で「東京の猫」と分かる、読めるURLになりました。
ファイル名も考え方は同じです。/admin/config/media/file-system の「Transliterate」を有効にすると、アップロードされたファイル名がUS-ASCIIに音訳されます。

もっとも、今どきの環境なら日本語のファイル名でも問題ないことがほとんどなので、これを使うかどうかは運用の好み次第です。ただ、ASCIIで統一したい場合、従来はピンイン読みになって何のファイルか分からなくなりがちでした。このモジュールを入れれば、その変換も日本語読みになります。
会員名簿.xlsx   →   (従来)huiyuanmingbu.xlsx
               →   (本モジュール)kaiin-meibo.xlsx
これらはいずれも、コアの音訳サービスを通る処理です。同じ仕組みで、ブロックのマシンネーム候補やmigrateでの音訳など、ほかの箇所にも自動的に効きます。
インストールは通常のコントリビュートモジュールと同じ手順です。前提として、JNLP モジュール と、その形態素解析サブモジュール(Sudachi・MeCab・Igo-phpのいずれか)を1つ以上有効にしておく必要があります。TinySegmenterは読みを返さないため対象外です。
なお、本モジュールは現時点ではベータ版のリリースのため、Drupalのセキュリティアドバイザリポリシーの対象外です(安定版のリリースで対象になります)。本番環境で利用する際はご留意ください。
有効化すると、/admin/config/regional/japanese-transliteration(「サイトの設定を管理」権限が必要)で次の3つを設定できます。
先ほどのプレビュー(入力中のサーバー問い合わせ)を有効にするには、権限をひとつ付与します。対象は、マシンネーム(フィールド・コンテンツタイプ・ビューなど)を編集するロールです。付与する権限は 「Access the Japanese transliteration endpoint」 です。
この権限や解析器が揃っていなくても、動作が壊れることはありません。権限がない、あるいは解析器が使えない場合、モジュールはエンドポイントに問い合わせず、コアのピンイン候補をそのまま維持します(解析器がなければサーバーも同じピンイン読みしか返せないため)。環境が揃っている場合にだけプレビューが日本語読みになる、という動作です。
なお、ファイル名のサニタイズやURLエイリアスの音訳はサーバー側(PHP)で処理される ため、この権限がなくても日本語読みになります。この権限が効くのは、あくまでフォーム画面でマシンネームを入力するときのプレビューです。
詳しい設定方法や制限事項は、モジュールのプロジェクトページとREADMEをご覧ください。
13年近く前から知られていて、1年前の自分が解ききれなかった課題を、ようやくDrupalコミュニティに還元する形で解決できました。小さなモジュールではありますが、日本語でDrupalを使うすべての人にとって、あの地味なストレスがひとつ減るはずです。
同じ「あるある」に心当たりがある日本語Drupalerの方は、ぜひ試してみてください。バグ報告やフィードバックも issue キュー でお待ちしています。
最後までお読みいただき、ありがとうございました。
大野 裕太郎
スタジオ・ウミ COO。Drupal 歴は20年を超え、コンサルティングや要件定義でプロジェクトを牽引しながら、社内のインフラ整備も自ら手がけています。サイトをいかに速く安定して表示させるかにこだわるパフォーマンス志向の技術者。座右の銘は「面白いことは、納得いくまでやる」。趣味は日本酒、車、バイク、男の料理。
小さなご意見も、私たちにとっては大きなヒントです!
ぜひ率直なご感想をお寄せください
この
Masters of Drupal Engineering.
人に、